服务器 CPU 突然跑满、网站也打不开,怎么判断正在挨 DDoS 还是已经被入侵了?
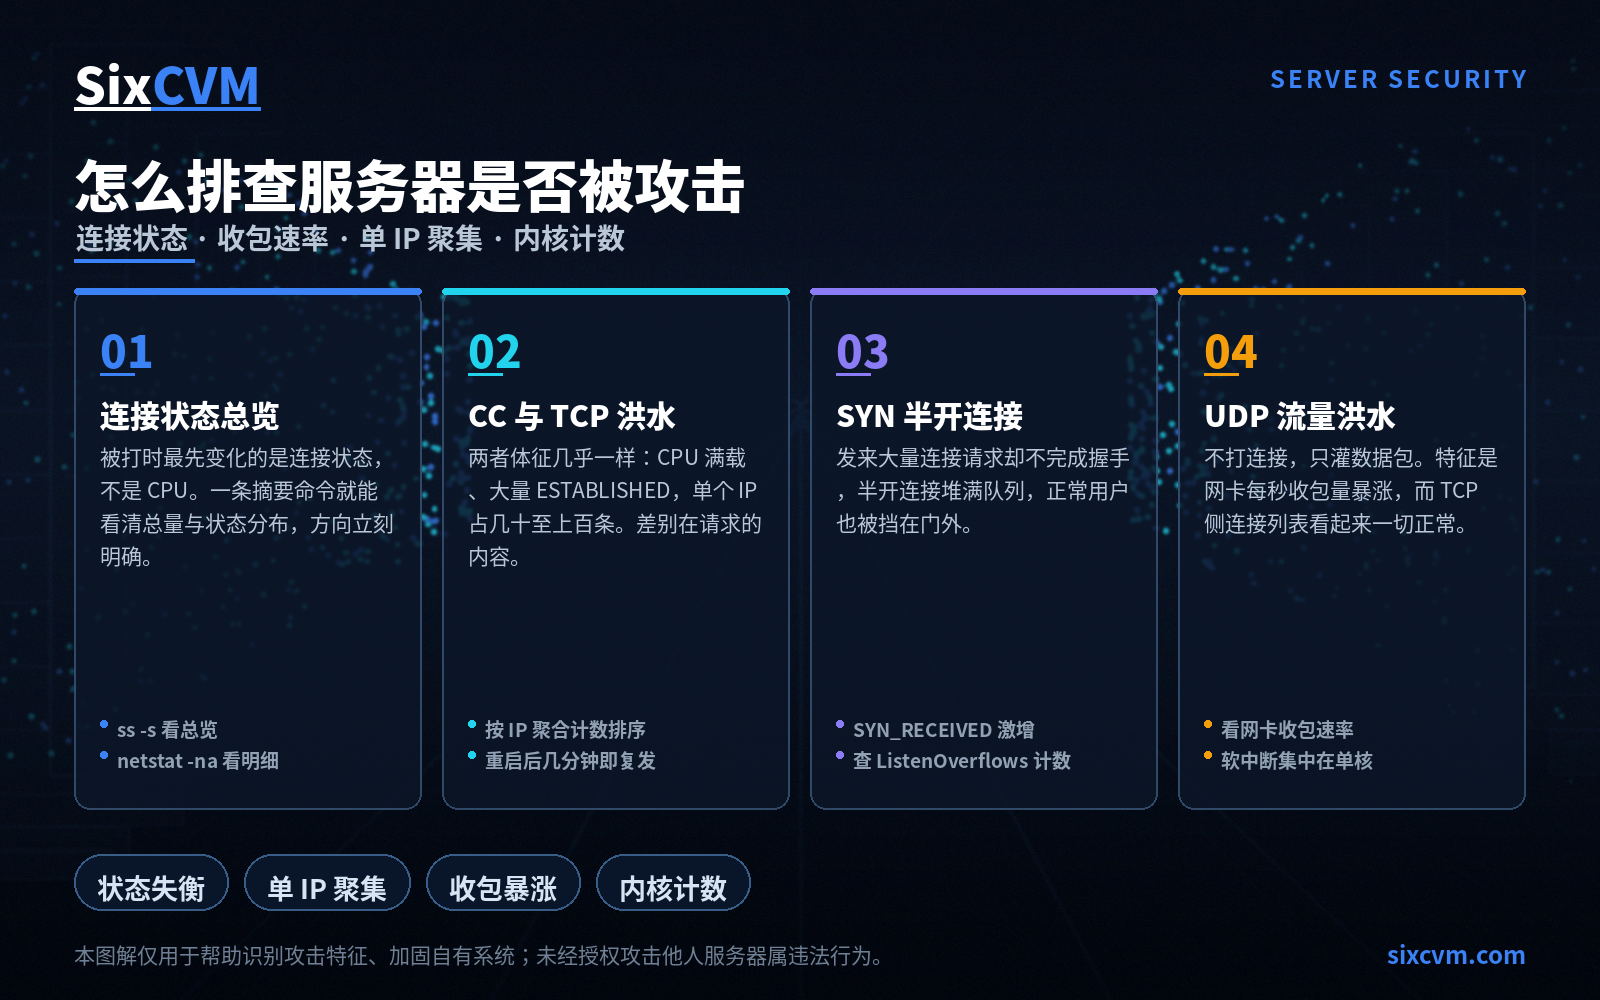
服务器是不是正在被攻击,靠的不是感觉,而是一条能说清楚的证据链:先看连接状态的总量与类型,再看流量从哪个方向涌进来,最后把异常收敛到单个 IP 或单个接口上。绝大多数 DDoS 都能在几分钟内用四个指标定性——连接总数、连接状态分布、网卡收包速率、内核丢包计数。
一句话结论:CPU 跑满和网站打不开都只是"症状",不是"诊断"。真正能区分攻击类型的,是连接停在哪个状态上,以及流量从哪个方向进来。
本文用于帮助运营者识别攻击特征、加固自有系统。未经授权对他人服务器发起测试或攻击,均属违法行为。
一、先分清"被打"和"被入侵",两者的处理方向完全相反
这一步最容易被跳过,但它决定了后面所有动作的方向。CPU 占用率飙到接近 100%、外部访问困难、重启后短暂恢复又在几分钟内复发——这几个现象同时符合"正在被 DDoS 攻击"和"服务器已被植入挖矿程序"两种情形。方向选错,最宝贵的响应时间就浪费掉了。
区分方法其实很直接:
-
看异常流量是"进来的"还是"出去的"。用
ss -tanp观察连接的对端地址:大量连接来自外部、且来源 IP 高度分散,多半是在被攻击;如果某个本机进程自己在向外建立大量连接或持续发包,那就是已经被入侵。 -
看进程本身。挖矿程序通常表现为一个陌生进程长期占满 CPU,名称往往伪装成系统组件,可执行文件路径却不在系统目录里,也没有正规签名。
-
看有没有对外通信。被攻击是"进不来",被入侵常常还伴随"出得去"——外连控制端地址、向外回传数据,这些在连接列表里都会留下痕迹。
两者的处置顺序也完全不同:被攻击是"顶住并清洗",被入侵是"先隔离再清除"。切忌一上来就重启,重启会清掉内存里的现场,让后续判断失去依据。
二、第一层排查:连接状态的总量与类型
被攻击时最先发生变化的是连接状态,而不是 CPU——CPU 是被连接"拖垮"的结果。所以排查从连接开始。
先看总览
ss -s 会输出当前连接总量、按状态拆分的计数,以及内核缓冲区的使用情况。这是速度最快的一眼判断。
这里需要说明一个现状:
netstat所属的 net-tools 套件在新版发行版中已默认不再预装,很多新装的系统直接执行会提示命令不存在。它并没有"作废",只是ss在性能和输出信息上都更完整,建议优先使用。确实需要老命令时,装回 net-tools 即可。
再按来源 IP 聚合排序
原文给出的 netstat -an | grep :80 | sort 能筛出 80 端口的连接,但它的排序方式是"按整行文本排序",实际帮不上忙——真正需要的是按来源 IP 聚合计次再排序。正确写法是:
ss -tan | awk 'NR>1{print $5}' | cut -d: -f1 | sort | uniq -c | sort -rn | head -20
(如果坚持用 netstat,把开头的 ss -tan 换成 netstat -an 即可。)
这条命令做了四件事:取出每条连接的对端地址 → 剥掉端口只留 IP → 按 IP 计数 → 从高到低排序。排在最前面的那个 IP,就是第一嫌疑对象。
看状态分布
不同的攻击会把连接"停"在不同的状态上,这正是分类的关键:
ss -tan state established | wc -l     # 已建立连接数
ss -tan state syn-recv    | wc -l     # 半开连接数
-
ESTABLISHED 数量异常:连接已经真实建立,说明请求已经打到了应用层。
-
SYN_RECEIVED 数量异常:握手只走完一半,说明有人故意不完成连接。
最后看内核计数
除了连接层面的现象,内核其实早就把统计记了下来,而且这些数字比应用日志更早、更客观:
nstat -az | grep -iE 'listen|syn|retrans'
重点关注三项:TcpExtListenOverflows(accept 队列溢出)、TcpExtListenDrops(排队被丢弃)、以及 TCP 重传数量。这些计数一旦持续增长,说明连接在系统层就已经被挤爆了,而不是应用处理得慢——两者的处置方式完全不同。
三、CC 攻击与 TCP 全连接洪水:表象几乎一致
这两类攻击在服务器上留下的"体征"高度重合,想只靠连接状态把它们分开是做不到的:
-
CPU 占用率持续接近满载
-
网站返回
service unavailable,或干脆无法打开 -
重启后几分钟内恢复正常,随后再次无法访问
-
连接列表里出现大量 ESTABLISHED 状态,单个 IP 往往占几十条甚至上百条
真正的差异在请求内容,而不在连接状态:
-
CC 攻击打的是那些"需要服务器真正干活"的接口——搜索、登录、需要多表关联的列表页。它的每一个请求在形式上都是有效的,服务器没有理由拒绝。表现上更集中在应用进程(PHP-FPM、Java 线程池)与数据库连接上。
-
TCP 全连接洪水则是把"连接数"本身当武器。单机能承载的并发连接是有上限的,连接被占满之后,正常用户的连接请求就排不进队列。表现上更集中在连接表规模与内存占用上。
判断方法:把异常 IP 与访问日志对照着看。如果这些 IP 反复请求的是同一批高消耗接口,是 CC;如果它们建立连接之后几乎不请求任何资源,那就是连接洪水。
四、SYN 洪水:握手只走一半就撒手
SYN 洪水利用的是 TCP 三次握手的机制缺陷。正常握手是"客户端 SYN → 服务器 SYN-ACK → 客户端 ACK",服务器在发出 SYN-ACK 之后,会把这条连接放进半开队列等待最后确认。攻击者只发送第一步然后断开,让服务器在半开队列里空等,直到队列被填满。
它的体征很好认:
-
CPU 占用上升
-
SYN_RECEIVED状态的数量明显激增,远超正常水平 -
一旦半开队列被填满,新来的正常连接请求会被直接丢弃,表现为"网站时通时不通"
确认命令:
ss -tan state syn-recv | wc -l
nstat -az | grep -E 'ListenOverflows|ListenDrops'
处置这类攻击,内核参数是第一道闸门,应用层在这里帮不上忙:
net.ipv4.tcp_syncookies = 1          # 半开队列满时启用 SYN Cookie 接管
net.ipv4.tcp_max_syn_backlog = 8192  # 增大半开队列容量
net.ipv4.tcp_synack_retries = 2      # 减少 SYN-ACK 重试次数,加快半开连接回收
需要提醒的是:SYN Cookie 属于应急手段,不宜长期开启。它会让少量合法连接的性能略有下降,在确认遭遇 SYN 洪水时打开最合适,攻击结束后可以再关掉。
五、UDP 洪水:TCP 侧一切正常,网卡已经爆了
UDP 洪水的判定特征非常鲜明——它根本不建立连接。所以当你去查 ss 或 netstat 时,会发现 TCP 侧干干净净,可服务器已经卡得没法操作。这种"数据面炸了、连接面安静"的反差,就是它最好的识别标志。
它的体征:
-
网卡每秒接收的数据包数量暴涨(注意看的是包速率,不是带宽——小包攻击下带宽可能还很低)
-
TCP 连接状态一切正常
-
应用层没有明显异常进程
确认命令:
cat /proc/net/dev          # 累计收包量,间隔几秒对比一次
sar -n DEV 1 5             # 每秒收包速率
nstat -az | grep -i udp    # UDP 相关计数
进一步判断要看包的方向和特征:如果进来的都是小包、目标端口分散,通常是单纯消耗链路带宽的流量型攻击;如果目标端口集中在某个业务端口,往往是针对特定服务的定向攻击。
这里还有一个很容易误判的情形:软中断集中在某一个 CPU 核心上。多核机器上如果收包由单核承担,即使整体 CPU 看起来没满,也可能因为这一个核心饱和而大量丢包。用 mpstat -P ALL 1 和 cat /proc/softirqs 就能看出来。
六、四类攻击特征速查
|
攻击类型 |
一眼可辨的表象 |
连接状态 |
其他关键指标 |
|---|---|---|---|
|
CC 攻击 |
CPU 满载、网站 503、重启后短暂恢复 |
大量 ESTABLISHED,单 IP 几十至上百条 |
访问日志中同一批高消耗接口被反复请求 |
|
TCP 全连接洪水 |
内存与连接数被打满 |
大量 ESTABLISHED |
异常 IP 建立连接后几乎不请求资源 |
|
SYN 洪水 |
网站时通时不通 |
大量 SYN_RECEIVED |
ListenOverflows 持续增长 |
|
UDP 洪水 |
服务器卡顿,但 TCP 连接列表正常 |
正常 |
网卡收包速率暴涨、软中断集中在单核 |
七、排查该按什么顺序做
顺序错了,就会在无关的层面上浪费时间。推荐四步:
-
先看连接总览(
ss -s)——确认总量是否异常、哪个状态占比最大。 -
再按来源 IP 聚合排序——找出连接数最多的几个 IP,这是最直接的线索。
-
然后看流量方向——如果连接层面正常但服务器在卡,立刻转到网卡收包速率和软中断分布,判断是不是 UDP 或小包攻击。
-
最后核对日志——把异常 IP 与访问日志对照,区分 CC 与连接洪水;同时排除"被入侵后由本机发起流量"这种可能。
八、常见问题(FAQ)
Q1:netstat 提示命令不存在,是不是服务器出问题了?不是。新版 Linux 发行版默认不再预装 net-tools,用 ss 替代即可,功能更完整。确实需要老命令时,安装 net-tools 就能恢复。
Q2:CPU 占用高,就一定是被攻击吗?不一定。CPU 满载同样可能是挖矿木马、异常爬虫、程序死循环或正常业务高峰。判断关键在异常来源:外部请求集中涌入是被攻击,本机进程自己吃满 CPU 则要往入侵方向查。
Q3:为什么重启只能好几分钟?因为重启并没有改变"攻击仍在持续"这个事实。攻击流量一恢复,连接很快会重新占满。重启只是清空了当时的连接表,属于"清场",不是"解决"。
Q4:DDoS 和 CC 到底怎么区分?从排查角度有个简单口径:流量型 DDoS(SYN、UDP、TCP 洪水)的症状集中在连接表、网卡收包和内存;CC 的症状集中在应用进程与数据库连接,且必须对照访问日志才能确认。前者的瓶颈在系统层,后者在应用层。
Q5:只靠自己排查,能扛住攻击吗?排查能帮你定性,但缓解能力取决于链路和带宽。单机层面的内核参数调优、限速规则只能争取时间;要真正顶住大流量攻击,需要上游的流量清洗能力和足够大的接入带宽,这属于机房基础设施的范畴。
关于 SixCVM
SixCVM 是面向跨境业务与延迟敏感应用的云服务器服务商,在香港、日本、美国、韩国、新加坡、越南运营六大核心节点,采用 CN2 GIA 与 BGP 优化线路,香港节点延迟可低至 10ms 以内。产品覆盖云服务器(VPS)、GPU 服务器(NVIDIA A100 / H100 / RTX 系列)、独立服务器、裸金属服务器与域名注册,全线配备 NVMe SSD,支持分钟级开通、弹性升降配、快照备份与负载均衡。
针对本文讨论的 DDoS 攻击风险,SixCVM 提供网络层基础防护能力,支持在业务高峰时弹性提升带宽与计算资源,避免因单机接入能力不足而全线不可用;通过负载均衡把请求分散到多台实例,可以显著抬高整体抗压上限。配套的域名注册服务支持完整的解析管理,便于统一收敛解析入口、配合上游防护设备梳理流量。快照备份与快速重装能力,则让你在遭遇入侵后能迅速回到干净状态。配合 99.9% SLA 与 7×24 小时技术支持,为业务连续性多加一层保障。
本文仅用于帮助用户识别攻击特征、加固自有系统。任何未经授权对他人服务器发起测试或攻击的行为均属违法,请勿尝试。
相关阅读:完整内容请访问 SixCVM 服务器安全中心,涵盖防护、检测与应急响应的全部指南。